

Die Veränderung des Medienkonsums stellt Broadcaster vor ein grundsätzliches Problem: Produktionen entstehen weiterhin im klassischen 16:9-Format für traditionelle Bildschirme, während ein wachsender Teil des Publikums Inhalte auf Smartphones konsumiert – in vertikalen Feeds auf TikTok, Instagram Reels oder YouTube Shorts. Gleichzeitig erwarten Zuschauer sofortige Verfügbarkeit von Highlight-Clips, während manuelle Nachbearbeitung oft erst nach Ende einer Veranstaltung abgeschlossen ist.
AWS Elemental Inference setzt an beiden Stellen an. Der Dienst analysiert eingehende Videoströme multimodal – also auf Basis von Bild und Audio – und wendet parallel zur laufenden Übertragung verschiedene KI-Funktionen an. Regina Rossi, Produktverantwortliche für AWS Media Services, beschreibt den Ansatz: „Unser Ziel ist es, Broadcaster dabei zu unterstützen, ihr Publikum dort abzuholen, wo es sich aufhält. Das bedeutet konkret: horizontale Videos automatisch in vertikale Formate umwandeln und Highlights in Echtzeit extrahieren."
Zwei Funktionen zum Start
Die erste Funktion adressiert die Formatkonvertierung. Das System erzeugt parallel zur ursprünglichen Ausstrahlung eine vertikale Version im 9:16-Format. Dabei erstellt es eine sogenannte Salience Map (KI-Werkzeug das visualisiert, welche konkreten Teile der Eingabedaten – etwa Pixel in einem Bild oder Wörter in einem Text – den Vorhersageprozess eines Machine-Learning-Modells am stärksten beeinflussen), die identifiziert, wo im Bild relevante Aktionen stattfinden. Bei Sportübertragungen kommt zusätzlich Object Tracking zum Einsatz, um Spieler oder den Ball zu verfolgen. Ein Glättungsalgorithmus sorgt dafür, dass die resultierende vertikale Ausgabe keine ruckartigen Schnitte aufweist. „Die Ausgabe erweckt den Eindruck einer manuellen Kameraführung", beschreibt Rossi das Ergebnis.
Die zweite Funktion betrifft die automatische Clip-Generierung. Das System erkennt Schlüsselmomente in Live-Übertragungen – etwa Tore, Touchdowns oder emotionale Höhepunkte – und extrahiert diese mit präzisen Start- und Endpunkten. Die generierten Clips können unmittelbar während einer laufenden Übertragung auf Social-Media-Plattformen verteilt werden. Rossi verweist auf den Zeitvorteil: „Der bisherige Prozess erfordert manuelles Sichten und Schneiden, was häufig erst nach Veranstaltungsende abgeschlossen ist. Bis dahin ist das virale Potenzial eines Clips oft schon verpufft."
Kontextbasierte Analyse statt Frame-für-Frame-Verarbeitung
Die Verarbeitung erfolgt kontextbasiert über Videosegmente hinweg, nicht auf Einzelbildbasis. „Wir analysieren, was im Video tatsächlich wichtig ist, statt nur einzelne Frames zu betrachten", erläutert Rossi. Diese kontextuelle Analyse erklärt die Latenz von sechs bis zehn Sekunden – das System benötigt einen gewissen Vorlauf, um die Bedeutung einer Szene einordnen zu können. Im Vergleich zu traditioneller Nachbearbeitung, die Minuten oder Stunden dauert, ermöglicht dieser Ansatz dennoch nahezu Echtzeit-Transformation.
AWS bezeichnet die Architektur als „process once, optimize everywhere": Mehrere KI-Funktionen laufen simultan auf demselben Videostrom, ohne dass Inhalte für jede Funktion erneut verarbeitet werden müssen.
Vollständig verwaltete Modelle ohne KI-Expertise
AWS positioniert den Dienst als vollständig verwaltete Lösung (fully-managed), die keine eigene KI-Expertise beim Kunden voraussetzt. Die zugrundeliegenden Foundation Models werden von AWS aktualisiert und optimiert, ohne dass Broadcaster Prompts erstellen oder Modelle trainieren müssen. Rossi beschreibt dies als bewusste Entscheidung: „Unsere Kunden berichten, dass sich KI-Modelle rasant weiterentwickeln. Kaum haben sie ein Modell evaluiert, erscheint bereits eine neue Version oder ein Konkurrenzmodell hat aufgeholt."
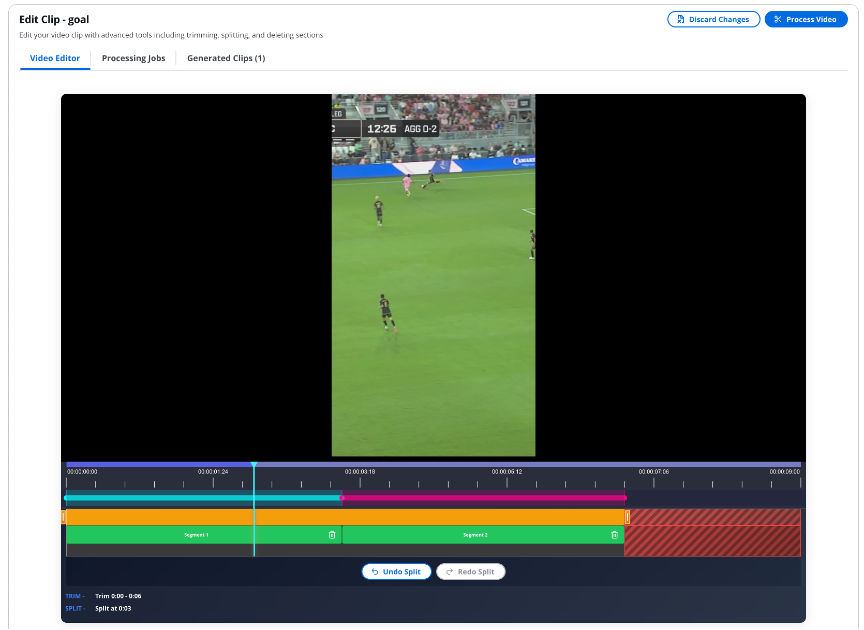
Die Abstraktion der KI-Komplexität bedeutet allerdings auch eingeschränkte Transparenz bezüglich der Entscheidungsprozesse. Kunden erhalten keine Einblicke in die einzelnen Modellentscheidungen, können aber bei der Clip-Generierung nachträglich Anpassungen vornehmen – etwa Start- und Endpunkte manuell korrigieren. „Unser Anspruch ist, dass Broadcaster KI einsetzen können, ohne auf dedizierte KI-Teams angewiesen zu sein", fasst Rossi zusammen.
Integration in bestehende AWS-Workflows
Der Dienst integriert sich in die bestehende AWS-Medieninfrastruktur. Broadcaster können AWS Elemental Inference über die MediaLive-Konsole aktivieren oder per API in ihre Workflows einbinden. Die GPU-Kapazitäten für die Modellberechnung stellt AWS bereit, Kunden benötigen keine eigene Hardware. Die Abrechnung erfolgt nutzungsbasiert nach verarbeiteten Videominuten und aktivierten Funktionen.
Der Dienst kann an verschiedenen Stellen in der Signalkette positioniert werden. Einige Kunden setzen ihn nahe der Contribution-Seite ein, um bereits vor der Produktion zu wissen, welche Inhalte und Metadaten im Video enthalten sind. Andere integrieren ihn direkt in den Encoding-Prozess, sodass horizontale und vertikale Ausgaben gleichzeitig aus einem einzigen Feed entstehen.
Zum Start ist AWS Elemental Inference in vier Regionen verfügbar: US East (Nord-Virginia), US West (Oregon), Europa (Irland) und Asien-Pazifik (Mumbai). AWS kündigt für den weiteren Jahresverlauf zusätzliche Funktionen an, darunter eine engere Integration mit den Kern-Diensten von Elemental sowie Features zur Monetarisierung von Videoinhalten.
Sport als erste Zielbranche
AWS fokussiert sich mit dem neuen Dienst zunächst auf Sportübertragungen. Fox und Peacock haben den Dienst bereits im Rahmen der Entwicklung getestet. Die Wahl des Sportsegments begründet Rossi mit dem hohen Wert von Live-Sportinhalten und der besonderen Eignung für Echtzeit-Optimierung: „Sport ist unser erster Fokusbereich, weil diese Inhalte für unsere Kunden besonders wertvoll sind und wir ihnen helfen können, das Potenzial dieses Contents besser auszuschöpfen."
Als weitere Anwendungsfelder nennt AWS Live-Streaming und Nachrichteninhalte. Die zugrundeliegende Technologie ist nicht auf Sport beschränkt, die multimodale Analyse funktioniert grundsätzlich mit allen Videoinhalten.


